MC-01a 自己相関
この種のモンテカルロシミュレーションでは、連続する標本は統計的に独立ではありません。各配位は直前の配位から生成されるため、データは時間方向に相関しています。 自己相関時間 は、2 つの標本を独立とみなせるようになるまでに何回の MC スイープを空ける必要があるかを表します。 が全スイープ数に比べて大きい場合、標本が独立であると仮定する素朴な誤差評価は小さすぎる値を与え、結果は信頼できません。 この問題は相転移点の近傍で最も深刻になります。そこでは相関長が発散し、局所更新は非常に非効率になります。
このチュートリアルでは、臨界温度における 2 次元イジング模型を用いてこの問題を示し、局所(メトロポリス)更新からクラスター更新に切り替えることで自己相関時間が劇的に短くなることを示します。 鍵となる診断手法はビニング解析です。標本を順次大きなビンにまとめながら誤差を再計算し、最大のビンサイズでも誤差がプラトーに達していなければ、自己相関時間がシミュレーションの長さより長いということであり、誤差は信頼できません。
このチュートリアルの入力ファイルは、お使いの ALPS ディストリビューションの mc-01-autocorrelations ディレクトリにあります。
局所更新
臨界温度 において、有限の正方格子(L=2, 4, …, 48)上のイジング模型を局所更新でシミュレートします。 このチュートリアルはコマンドラインでも Python でも実行できます。手元のマシンでは Python 版を、クラスタ上での大規模シミュレーションではコマンドライン版をお勧めします。
コマンドラインでのシミュレーションの設定と実行
コマンドラインでシミュレーションを設定して実行するには、まずシミュレーションのパラメータを指定するパラメータファイルを作成します。ダウンロードできるファイルの名前は parm1a で、内容は次のとおりです。
LATTICE="square lattice"
T=2.269186
J=1
THERMALIZATION=10000
SWEEPS=50000
UPDATE="local"
MODEL="Ising"
{L=2;}
{L=4;}
{L=8;}
{L=16;}
{L=32;}
{L=48;}
これは実際には 1 つのシミュレーションジョブの中で 6 つのシミュレーションタスクを指定しており、格子の一辺 L を除いてすべてのタスクのパラメータは同一です。
ALPS はジョブ全体を記述する 1 つのジョブファイルと、その中の各シミュレーションタスクに対応するタスクファイルを必要とし、いずれも XML 形式です。したがってシミュレーションを実行するには、まずこのパラメータファイルを変換する必要があります。ALPS にはそのための簡単なツールが用意されています。
parameter2xml parm1aをパラメータファイルのあるディレクトリで実行します。これにより、parm1a.task1.in.xml から parm1a.task6.in.xml までの 6 つのタスクファイル(各辺長 L に 1 つずつ)と、ジョブ記述ファイル parm1a.in.xml が生成されます。シミュレーションを開始したあとは、このジョブファイルを XML ブラウザで開いて状況を確認できます。
単一プロセッサでは次のようにしてシミュレーションを開始できます。
spinmc --Tmin 10 --write-xml parm1a.in.xmlあるいは MPI を使って複数プロセッサ(この例では 8 個)で実行することもできます。
mpirun -np 8 spinmc --mpi --Tmin 10 --write-xml parm1a.in.xml (以下の例では単一プロセッサ用のコマンドのみを示します。)引数 --Tmin 10 を設定することで、最初はシミュレーションが終了したかどうかを 10 秒ごとに確認するようスケジューラに指示します。(この時間はその後、シミュレーションの必要に応じてスケジューラが動的に調整します。)
シミュレーションの進行状況は、実行中に XML 出力ファイルへ保存されます。Ctrl-C を押した場合や CPU 時間の上限に達した場合などでシミュレーションが停止したときは、入力ジョブファイルの代わりに XML 出力ファイルを指定して起動することで計算を再開できます。入力ジョブファイルの名前が parm1a.in.xml であったため、出力ファイルは parm1a.out.xml となり、次のようにして再開できます。
spinmc --Tmin 10 --write-xml parm1a.out.xmlオプション “–write-xml” は、各シミュレーションの結果を XML 出力ファイル(parm1a.task\[1-6\].out.xml)にも保存するよう指示します。これらはジョブ記述ファイル parm1a.out.xml から XML ブラウザで開くことができ、あるいは次のいずれかのコマンドでテキストファイルに変換することもできます。
firefox ./parm1a.out.xml
convert2text parm1a.out.xml
たとえば parm1a.task1.out.xml に保存された 1 つのタスクの結果は、次のいずれかのコマンドで表示できます。
- Linux:
firefox ./parm1a.task1.out.xml - MacOS:
open -a safari parm1a.task1.out.xml - テキスト出力:
convert2text parm1a.task1.out.xml
多数の測定を行う場合、XML ファイルの書き出しは非常に遅くなることがあります。その場合は HDF5 ファイル内のバイナリ結果を扱うほうがよいでしょう。
誤差の収束を確認するなど、シミュレーションの実行についてより詳細な情報を得るには、各タスクの実行ファイル(parm1a.task\[1-6\].out.run1)を次のように入力して XML ファイルに変換できます。
convert2xml parm1a.task*.out.run1これにより XML 出力ファイル parm1a.task\[1-6\].out.run1.xml が生成されます。これらは出力 XML ファイルと同様に開いたりテキストに変換したりできます。
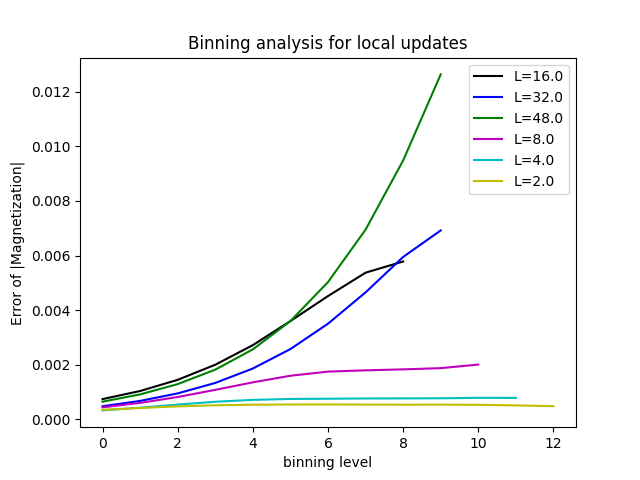
6 つのタスクすべてを確認し、ファイル parm1a.task\[1-6\].out.run1.xml 内のビニング解析を調べることで、大きな格子では誤差がもはや収束しないことを観察してください。図を作成するには、以下で説明する Python ツールの利用をお勧めします。
Python でのシミュレーションの設定と実行
pyalps パッケージは ALPS のラッパーです。前節で説明したコマンドを、あたかも端末で実行するかのように呼び出すだけのものです。シミュレーションの出力を直接 Python のデータ構造に読み込んで matplotlib から利用できるため、作図に関して優れています。また、pyalps が生成したデータをきれいに描画するために、一部の matplotlib 関数に対するラッパー pyalps.plot も備えています。
Python でシミュレーションを設定して実行するために、tutorial1a.py という名前のスクリプトを作成します。このスクリプトの最初の部分では、必要なモジュールをインポートし、入力ジョブファイルとタスクファイルを準備します。パラメータファイルを書いて convert2xml を使う代わりに、次のように各タスクのパラメータを辞書としてリストに格納します。
import pyalps
import matplotlib.pyplot as plt
import pyalps.plot

parms = []
for l in [2,4,8,16,32,48]:
    parms.append(
        {
            'LATTICE'        : "square lattice",
            'T'              : 2.269186,
            'J'              : 1 ,
            'THERMALIZATION' : 10000,
            'SWEEPS'         : 50000,
            'UPDATE'         : "local",
            'MODEL'          : "Ising",
            'L'              : l
        }
    )
そして次の関数でこれを XML ジョブファイルに変換します。
input_file = pyalps.writeInputFiles('parm1a',parms)変数 input_file は、以下のように pyalps.runApplication の入力として使用できます。
pyalps.runApplication('spinmc',input_file,Tmin=5,writexml=True)spinmc は呼び出される端末コマンドの名前です。オプション writexml=True は XML ファイルを書き出すよう ALPS に指示し、input_file は XML ジョブ入力ファイルのパス、Tmin=5 は先ほどと同様にシミュレーションの完了を 5 秒ごとに確認するよう ALPS に指示します。
次に、pyalps.loadBinningAnalysis を用いて出力ファイルから磁化の絶対値のビニング解析を読み込み、得られた入れ子のリストを pyalps.flatten で平坦化します。
binning = pyalps.loadBinningAnalysis(pyalps.getResultFiles(prefix='parm1a'),'|Magnetization|')
binning = pyalps.flatten(binning)
凡例に表示して格子サイズを識別できるよう、各データセットにラベルを付けます。
for dataset in binning:
    dataset.props['label'] = 'L='+str(dataset.props['L'])
pyalps.plot の関数はこれらのラベルを自動的に使用します。最後に、ビニング解析を示す図を作成します。
plt.figure()
plt.xlabel('binning level')
plt.ylabel('Error of |Magnetization|')
pyalps.plot.plot(binning)
plt.legend()
plt.show()
システムサイズごとに別々の図を作成するには、すべてのデータセットについてループを回します。
for dataset in binning:
    plt.figure()
    plt.title('Binning analysis for L='+str(dataset.props['L']))
    plt.xlabel('binning level')
    plt.ylabel('Error of |Magnetization|')
    pyalps.plot.plot(dataset)

plt.show()
以下の図から、大きなシステムサイズでは誤差が収束していないことがはっきりと分かります。
クラスター更新
臨界温度の近傍では相関長 が大きくなり、局所更新は極めて非効率になります。受理される更新は 1 個のスピンを反転させるだけなので、隣接する 2 つのスピンの相関を解くだけでも 回のスイープを要します。 この臨界緩和により、自己相関時間は次のように発散します。
ここで は動的臨界指数です。 これは自己相関時間が相関長とともにどれだけ速く増大するかを表し、 となります。 では相関長が格子サイズで打ち切られて となるため、 が得られます。 静的な臨界指数とは異なり、 はモデルだけで決まる量ではなく、シミュレーションに用いる更新アルゴリズムに依存します。局所更新では ですが、Wolff や Swendsen–Wang のようなクラスターアルゴリズムでは です。 クラスター更新は相関した領域全体を一度に反転させるため、ここで測定する量については臨界緩和を実質的に取り除きます。
そこで、熱化スイープを減らし(系の相関がはるかに速く解けるため)、良い統計を蓄積するために測定スイープを増やして、クラスター更新でシミュレーションを繰り返します。
| パラメータ | 値 |
|---|---|
| THERMALIZATION | 1000 |
| SWEEPS | 100000 |
| UPDATE | “cluster” |
コマンドライン
ダウンロードできるパラメータファイル parm1b の内容は次のとおりです。
LATTICE="square lattice"
T=2.269186
J=1
THERMALIZATION=1000
SWEEPS=100000
UPDATE="cluster"
MODEL="Ising"
{L=2;}
{L=4;}
{L=8;}
{L=16;}
{L=32;}
{L=48;}
先ほどとまったく同じ手順で変換して実行します。
parameter2xml parm1b
spinmc --Tmin 10 --write-xml parm1b.in.xml
Python
スクリプト tutorial1b.py は tutorial1a.py と同じ構成で、パラメータを更新し、ファイルの接頭辞を parm1b にしたものです。
import pyalps
import matplotlib.pyplot as plt
import pyalps.plot

parms = []
for l in [2,4,8,16,32,48]:
    parms.append(
        {
            'LATTICE'        : "square lattice",
            'T'              : 2.269186,
            'J'              : 1,
            'THERMALIZATION' : 1000,
            'SWEEPS'         : 100000,
            'UPDATE'         : "cluster",
            'MODEL'          : "Ising",
            'L'              : l
        }
    )

input_file = pyalps.writeInputFiles('parm1b', parms)
pyalps.runApplication('spinmc', input_file, Tmin=5, writexml=True)

binning = pyalps.loadBinningAnalysis(pyalps.getResultFiles(prefix='parm1b'), '|Magnetization|')
binning = pyalps.flatten(binning)

for dataset in binning:
    dataset.props['label'] = 'L=' + str(dataset.props['L'])

plt.figure()
plt.xlabel('binning level')
plt.ylabel('Error of |Magnetization|')
pyalps.plot.plot(binning)
plt.legend()
plt.show()
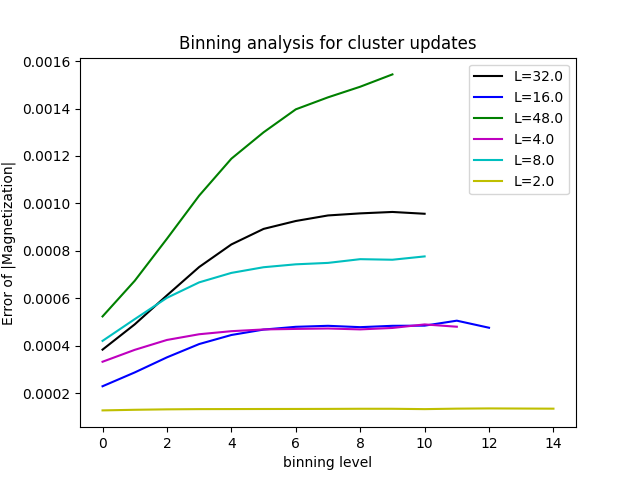
以下のような曲線が得られます。局所更新に比べて誤差はずっと早く頭打ちになります。 では誤差がプラトーに達しており信頼できますが、 では最大のビニングレベルでも誤差がまだわずかに増加しているため、完全に収束させるにはより長い計算が必要です。
問題
問題をクリックすると解答が表示され、もう一度クリックすると隠れます。
1. 誤差は収束していますか。(上で説明したように実行ファイルを変換して確認してください。)
誤差の評価値は、ビニングレベルを上げたときにプラトーに達していれば収束しています。答えは更新方法によって異なります。
- 局所更新: 明らかに収束しているのは最小の格子()だけで、 はほぼ平坦です。 では最大のビニングレベルでも誤差が急激に増加し続けているため、これらの誤差は信頼できません。
- クラスター更新: では誤差がプラトーに達しています。 では最大のビニングレベルでも誤差がまだわずかに増加しているため、収束に近いものの完全には収束していません。
2. 自己相関時間が長いと、なぜ誤差の収束が遅くなるのでしょうか。
連続する測定値は互いに相関しているため、 回の測定には統計的に独立な標本がおよそ 個しか含まれません。そのため、標本が独立であると仮定する素朴な誤差は、およそ 倍小さく見積もられます。
ビンの長さが より十分長くなって初めて隣り合うビンが実質的に独立になり、ビニングによってこの偏りが取り除かれます。したがって自己相関時間が長いほど、プラトーが現れるビニングレベルは高くなります。高いビニングレベルでは残るビンの数が少ないため誤差の評価値はばらつきが大きくなり、 が計算の長さと同程度であれば、プラトーにはまったく到達しません。
(これは熱化とは異なります。熱化は、結果が初期配置に依存しないように計算の最初の部分を捨てることです。)
3. 自己相関時間は系のどのパラメータに依存するでしょうか。入力ファイルのパラメータを変えて確認してください。
- 温度: 相関長 が発散する臨界温度 の近くで自己相関時間は最大になります。 から離れると(例えば や を試してください)、 したがって はずっと小さくなります。
- 系のサイズ: では相関長は格子サイズによってのみ制限されるため、 は とともに増大します。ビニングのプロットで大きな格子ほど収束が悪いのはこのためです。
- 更新アルゴリズム: これは物理的なパラメータではありませんが、 における動的臨界指数 を決めます。局所更新ではおよそ 2、クラスター更新ではおよそ 0.25 です。
自己相関時間は測定する物理量にも依存するため、同じ計算でも物理量ごとに が異なることがあります。
4. クラスター更新が局所更新より効率的である理由を説明できますか。
の近くでは、スピンはおよそ の大きさの、向きのそろった大きなドメインを形成します。局所更新は 1 個のスピンの反転を試みますが、そろったドメインの内部のスピンを反転させるとエネルギーが増えるため、通常は棄却されます。そのためドメインは磁壁のゆっくりとしたランダムな運動によってしか変化せず、これにはおよそ 回のスイープを要します。これが臨界緩和であり、 に対応します。
Wolff や Swendsen–Wang のようなクラスターアルゴリズムは、向きのそろった隣接スピンを確率 で結んでクラスターを作ります。これらのクラスターは相関したドメインに対応し、クラスター全体の反転は常に受理されます。そのため 1 回のクラスター更新で のスケールで配置が変わり、連続する配置は数回の更新で相関が失われます()。
利点は 1 回の更新の計算が速いことではありません。各更新で得られる配置の相関がはるかに弱いため、同じ統計精度に必要なスイープ数がずっと少なくて済むのです。