MC-01a 自关联
在这类蒙特卡洛模拟中,相继的样本并不是统计独立的:每个组态都由前一个组态生成,因此数据在时间上是关联的。 自关联时间 衡量的是两个样本之间必须相隔多少个蒙特卡洛扫描,才能被视为彼此独立。 如果 与总扫描次数相比很大,那么朴素的误差估计——它假设样本相互独立——就会偏小,结果也就不可信。 这一问题在相变点附近最为严重,此时关联长度发散,局域更新变得非常低效。
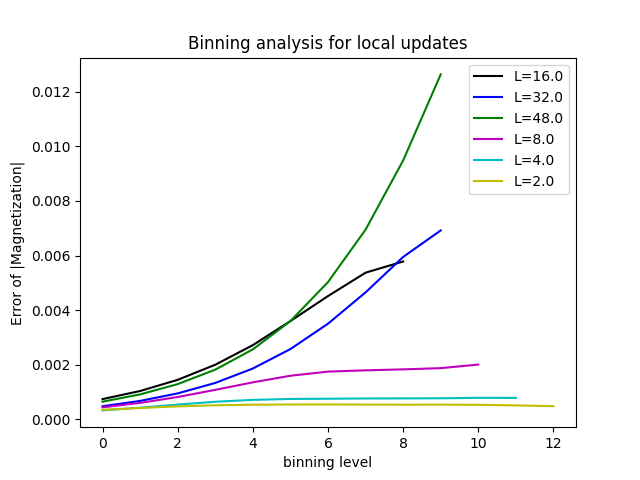
本教程以处于临界温度的二维伊辛模型为例展示这一问题,并说明从局域(Metropolis)更新改为团簇更新如何显著缩短自关联时间。 关键的诊断工具是分箱分析:把样本合并成越来越大的箱子后重新计算误差;如果在最大的箱子尺寸下估计的误差仍未趋于平台,就说明自关联时间比整个模拟还长,误差不可信。
本教程的输入文件可以在你的 ALPS 发行版的 mc-01-autocorrelations 目录中找到。
局域更新
我们将在临界温度 下,使用局域更新模拟有限正方格子(L=2, 4, …, 48)上的伊辛模型。 本教程既可以在命令行下运行,也可以在 Python 中运行。我们推荐在本地机器上使用 Python 版本,而在集群上进行大规模模拟时使用命令行版本。
在命令行下设置并运行模拟
要在命令行下设置并运行模拟,我们首先创建一个参数文件来指定模拟的各项参数。可下载的文件名为 parm1a,内容如下:
LATTICE="square lattice"
T=2.269186
J=1
THERMALIZATION=10000
SWEEPS=50000
UPDATE="local"
MODEL="Ising"
{L=2;}
{L=4;}
{L=8;}
{L=16;}
{L=32;}
{L=48;}
这实际上在一个模拟作业中指定了六个模拟任务,除格子边长 L 之外,所有任务的参数都完全相同。
ALPS 需要用一个作业文件来描述整个作业,并为其中的每个模拟任务提供一个任务文件,它们都采用 XML 格式。因此,为了运行模拟,我们首先需要转换这个参数文件。ALPS 提供了一个简单的工具来完成这项工作:
parameter2xml parm1a在参数文件所在的目录下执行。这会生成六个任务文件(每个边长 L 一个),名为 parm1a.task1.in.xml 到 parm1a.task6.in.xml,以及一个作业描述文件 parm1a.in.xml。模拟启动之后,我们可以用 XML 浏览器打开这个作业文件来查看模拟状态。
在单个处理器上可以这样启动模拟:
spinmc --Tmin 10 --write-xml parm1a.in.xml也可以用 MPI 在多个处理器上运行(本例中为 8 个):
mpirun -np 8 spinmc --mpi --Tmin 10 --write-xml parm1a.in.xml (在后面的例子中我们只给出单处理器的命令。)通过设置参数 --Tmin 10,我们告诉调度器最初每隔 10 秒检查一次模拟是否结束。(之后调度器会根据模拟的需要动态调整这一时间间隔。)
模拟的进展会在运行过程中保存到 XML 输出文件中。如果模拟被中断,例如按下 Ctrl-C 或达到 CPU 时间上限,可以用 XML 输出文件(而不是输入作业文件)来启动模拟,从而继续计算。由于我们的输入作业文件名为 parm1a.in.xml,输出文件将被命名为 parm1a.out.xml,我们可以这样重新启动模拟:
spinmc --Tmin 10 --write-xml parm1a.out.xml选项 “–write-xml” 告诉模拟程序把每次模拟的结果也保存到 XML 输出文件(parm1a.task\[1-6\].out.xml)中,你可以从作业描述文件 parm1a.out.xml 出发,用 XML 浏览器打开它们,或者用下面的命令之一把输出转换成文本文件:
firefox ./parm1a.out.xml
convert2text parm1a.out.xml
单个任务的结果(例如保存在 parm1a.task1.out.xml 中的结果)可以用下列任一命令显示:
- Linux:
firefox ./parm1a.task1.out.xml - MacOS:
open -a safari parm1a.task1.out.xml - 文本输出:
convert2text parm1a.task1.out.xml
注意,如果你进行了大量测量,写入 XML 文件可能会非常慢,这时最好使用 HDF5 文件中的二进制结果。
为了获得关于模拟运行的更详细信息,例如检查误差的收敛情况,我们可以用下面的命令把各任务的运行文件(parm1a.task\[1-6\].out.run1)转换成 XML 文件:
convert2xml parm1a.task*.out.run1这会生成 XML 输出文件 parm1a.task\[1-6\].out.run1.xml,它们可以像输出 XML 文件一样被打开或转换成文本。
请查看全部六个任务,并通过研究文件 parm1a.task\[1-6\].out.run1.xml 中的分箱分析,观察到对于较大的格子,误差不再收敛。若要作图,我们建议使用下面介绍的 Python 工具。
在 Python 中设置并运行模拟
pyalps 包是 ALPS 的一个封装:它所做的只是像在终端里那样调用上一节介绍的命令。它在作图方面更有优势,因为模拟的输出可以直接读入 Python 数据结构,并由 matplotlib 访问。它还为某些 matplotlib 函数提供了封装 pyalps.plot,可以整洁地绘制由 pyalps 生成的数据。
要在 Python 中设置并运行模拟,我们创建一个名为 tutorial1a.py 的脚本。脚本的第一部分必须导入所需的模块,并准备输入作业文件和任务文件。我们不再编写参数文件并使用 convert2xml,而是把每个任务的参数以字典的形式存放在一个列表中,如下所示:
import pyalps
import matplotlib.pyplot as plt
import pyalps.plot

parms = []
for l in [2,4,8,16,32,48]:
    parms.append(
        {
            'LATTICE'        : "square lattice",
            'T'              : 2.269186,
            'J'              : 1 ,
            'THERMALIZATION' : 10000,
            'SWEEPS'         : 50000,
            'UPDATE'         : "local",
            'MODEL'          : "Ising",
            'L'              : l
        }
    )
然后用下面的函数把它转换成 XML 作业文件:
input_file = pyalps.writeInputFiles('parm1a',parms)变量 input_file 可以作为 pyalps.runApplication 的输入,如下所示:
pyalps.runApplication('spinmc',input_file,Tmin=5,writexml=True)spinmc 是要调用的终端命令名。选项 writexml=True 告诉 ALPS 写出 XML 文件,input_file 是 XML 作业输入文件的路径,而 Tmin=5 同样告诉 ALPS 每隔 5 秒检查一次模拟是否完成。
接下来我们用 pyalps.loadBinningAnalysis 从输出文件中载入磁化强度绝对值的分箱分析,并用 pyalps.flatten 把得到的嵌套列表展平:
binning = pyalps.loadBinningAnalysis(pyalps.getResultFiles(prefix='parm1a'),'|Magnetization|')
binning = pyalps.flatten(binning)
我们给每个数据集加上一个标签,它会出现在图例中以标识格子尺寸:
for dataset in binning:
    dataset.props['label'] = 'L='+str(dataset.props['L'])
pyalps.plot 函数会自动使用这些标签。最后,我们作出展示分箱分析的图:
plt.figure()
plt.xlabel('binning level')
plt.ylabel('Error of |Magnetization|')
pyalps.plot.plot(binning)
plt.legend()
plt.show()
如果要为每个系统尺寸分别作图,我们对所有数据集做一个循环:
for dataset in binning:
    plt.figure()
    plt.title('Binning analysis for L='+str(dataset.props['L']))
    plt.xlabel('binning level')
    plt.ylabel('Error of |Magnetization|')
    pyalps.plot.plot(dataset)

plt.show()
从下图中可以清楚地看到,对于较大的系统尺寸,误差并不收敛。
团簇更新
在临界温度附近,关联长度 变得很大,局域更新会变得非常低效:每次被接受的移动只翻转一个自旋,因此仅仅为了让两个相邻自旋去关联就需要 次扫描。 这种临界慢化意味着自关联时间按下式发散
其中局域更新对应 ,而 Wolff 或 Swendsen–Wang 等团簇算法对应 。 团簇更新一次翻转整片彼此关联的区域,对于这里所测量的物理量基本上消除了临界慢化。
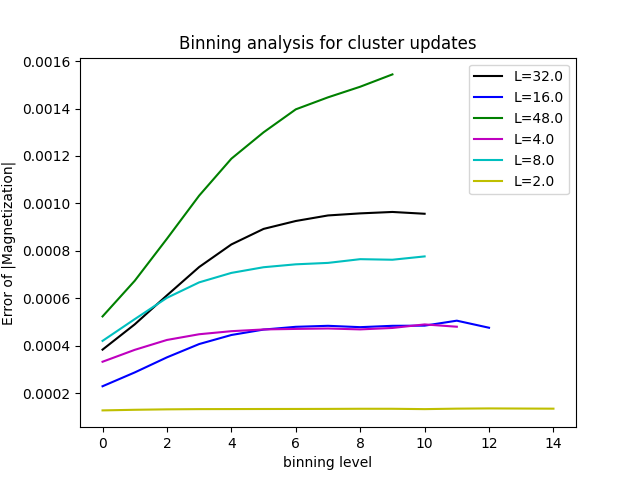
因此,我们改用团簇更新重复这些模拟,其中热化扫描次数更少(系统去关联要快得多),但测量扫描次数更多,以积累良好的统计:
| 参数 | 取值 |
|---|---|
| THERMALIZATION | 1000 |
| SWEEPS | 100000 |
| UPDATE | “cluster” |
命令行
可下载的参数文件 parm1b 内容如下:
LATTICE="square lattice"
T=2.269186
J=1
THERMALIZATION=1000
SWEEPS=100000
UPDATE="cluster"
MODEL="Ising"
{L=2;}
{L=4;}
{L=8;}
{L=16;}
{L=32;}
{L=48;}
按照与前面完全相同的方式转换并运行:
parameter2xml parm1b
spinmc --Tmin 10 --write-xml parm1b.in.xml
Python
脚本 tutorial1b.py 与 tutorial1a.py 结构相同,只是更新了参数并把文件前缀改为 parm1b:
import pyalps
import matplotlib.pyplot as plt
import pyalps.plot

parms = []
for l in [2,4,8,16,32,48]:
    parms.append(
        {
            'LATTICE'        : "square lattice",
            'T'              : 2.269186,
            'J'              : 1,
            'THERMALIZATION' : 1000,
            'SWEEPS'         : 100000,
            'UPDATE'         : "cluster",
            'MODEL'          : "Ising",
            'L'              : l
        }
    )

input_file = pyalps.writeInputFiles('parm1b', parms)
pyalps.runApplication('spinmc', input_file, Tmin=5, writexml=True)

binning = pyalps.loadBinningAnalysis(pyalps.getResultFiles(prefix='parm1b'), '|Magnetization|')
binning = pyalps.flatten(binning)

for dataset in binning:
    dataset.props['label'] = 'L=' + str(dataset.props['L'])

plt.figure()
plt.xlabel('binning level')
plt.ylabel('Error of |Magnetization|')
pyalps.plot.plot(binning)
plt.legend()
plt.show()
你会得到类似下图的曲线。现在误差已经收敛,可以信赖了。
思考题
- 误差收敛了吗?(可以按照上面介绍的方法转换运行文件来检查。)
- 为什么更长的自关联时间会导致误差收敛得更慢?
- 自关联时间依赖于系统的哪些参数?可以通过修改输入文件中的参数来检验。
- 你能解释为什么团簇更新比局域更新更高效吗?